1. Unternehmensüberblick
Ein führendes Finanzdienstleistungsunternehmen mit Schwerpunkt auf Vermögensverwaltung, Investmentbanking und Finanzberatung. Das Unternehmen betreut weltweit Millionen Kunden und bietet Privatpersonen, Unternehmen und Institutionen maßgeschneiderte Finanzlösungen.
2. Geschäftliche Herausforderungen
Das Unternehmen stand vor mehreren Herausforderungen im Umgang mit Daten:
- Datensilos: Daten waren über mehrere Systeme verteilt, was eine einheitliche Sicht auf Kundeninteraktionen und Finanztransaktionen erschwerte.
- Komplexe Datenintegration: Die Integration von Daten aus unterschiedlichen Quellen wie Handelssystemen, CRM-Plattformen und externen Marktdatenanbietern war zeitaufwendig und fehleranfällig.
- Bedarf an Echtzeitanalysen: Das Unternehmen benötigte Analysen nahezu in Echtzeit, um Entscheidungen im Handel und Risikomanagement zu unterstützen.
- Skalierungsprobleme: Die bestehende Dateninfrastruktur konnte mit dem wachsenden Transaktionsvolumen und den steigenden Anforderungen an Datenanalysen nur schwer Schritt halten.
3. Lösung
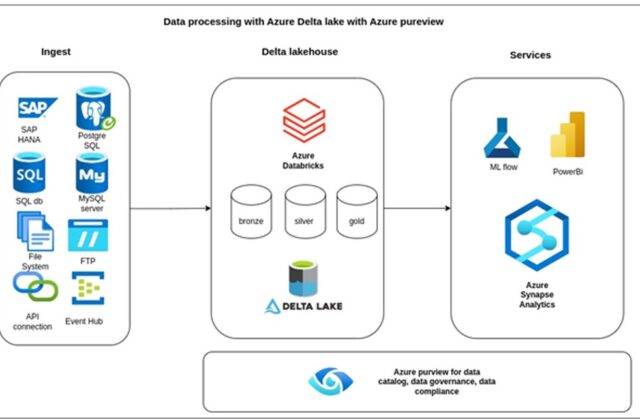
Um diese Herausforderungen zu bewältigen, implementierte das Unternehmen eine Datenarchitektur auf Basis von Azure Synapse Analytics. Die Lösung integrierte verschiedene Synapse-Komponenten, darunter Pipelines, Notebooks, Spark Pools, Dedicated SQL Pools und das Synapse Data Warehouse.
- Azure Data Factory für Datenintegration und -transformation.
- Azure Data Lake Storage für sichere und skalierbare Datenspeicherung.
- Azure Databricks für erweiterte Analysen und KI-Funktionen.
- Azure Purview für Data Governance, Katalogisierung und Klassifizierung.
4. Lösungsarchitektur
1. Datenaufnahme: Azure Synapse Pipelines* wurden eingesetzt, um die Datenaufnahme aus verschiedenen Quellen zu orchestrieren. Daten aus Transaktionsdatenbanken, Marktdaten-Feeds und CRM-Systemen wurden in Azure Data Lake Storage (ADLS) Gen2 aufgenommen.
2. Datenverarbeitung und -transformation: Synapse Notebooks und *Spark Pools* wurden für ETL-Prozesse (Extract, Transform, Load) eingesetzt. Rohdaten in ADLS wurden mit Spark-Jobs bereinigt, transformiert und angereichert.
Workflows zur Datentransformation wurden mit Synapse Pipelines geplant und automatisiert, sodass verarbeitete Daten rechtzeitig verfügbar waren.
3. Datenspeicherung: Transformierte Daten wurden in den *Dedicated SQL Pool* innerhalb von Synapse Analytics geladen, der als Data Warehouse diente.
Das Data Warehouse speicherte sowohl historische Daten als auch Daten nahezu in Echtzeit und war für eine hohe Abfrageleistung optimiert.
4. Datenmodellierung und Aggregation: Das Data Warehouse wurde mit einem Sternschema aufgebaut, das effiziente Abfragen und Berichte ermöglichte. Faktentabellen speicherten Transaktionsdaten, während Dimensionstabellen Referenzdaten enthielten.
5. Datenanalyse und Berichterstattung: Das einheitliche Data Warehouse ermöglichte komplexe Abfragen und Analysen mithilfe der Synapse-SQL-Funktionen.
Das Unternehmen nutzte Synapse Studio für die interaktive Erkundung und Analyse von Daten.
Power BI wurde für erweiterte Datenvisualisierung und Berichterstattung integriert, sodass Fachanwender Erkenntnisse aus dem Data Warehouse gewinnen konnten.
6. Data Governance und Sicherheit: Data-Governance-Richtlinien wurden eingeführt, um Datenqualität und Compliance sicherzustellen. Azure Data Catalog wurde zur Datensuche und Metadatenverwaltung eingesetzt.
Rollenbasierte Zugriffskontrolle (RBAC) und Datenverschlüsselung gewährleisteten Datensicherheit und Datenschutz.
5. Geschäftlicher Nutzen
- Verbesserte Entscheidungsfindung: Das Unternehmen erhielt eine einheitliche Sicht auf Kundendaten, die bessere Entscheidungen und personalisierte Finanzberatung ermöglichte.
- Höhere Leistung: Die skalierbare und leistungsfähige Synapse-Architektur verarbeitete große Datenmengen effizient und unterstützte Echtzeitanalysen und Berichterstattung.
- Betriebliche Effizienz: Automatisierte Datenpipelines verringerten den Zeit- und Arbeitsaufwand für Datenintegration und -transformation und steigerten so die betriebliche Effizienz.
- Skalierbarkeit und Flexibilität: Die Lösung bot die nötige Skalierbarkeit für wachsende Datenmengen und Analyse-Workloads und sicherte damit die langfristige Tragfähigkeit.
- Compliance und Sicherheit: Robuste Maßnahmen für Data Governance und Sicherheit gewährleisteten die Einhaltung regulatorischer Anforderungen und schützten Kundendaten.