In der Datentechnik ist es entscheidend, Workflows für große Datenmengen zuverlässig und effizient zu verwalten. Je komplexer Datensätze werden, desto eher stoßen herkömmliche Ansätze bei Skalierbarkeit, Ressourcenverwaltung und Zusammenarbeit an ihre Grenzen. Hier kommt Kubeflow ins Spiel: ein quelloffenes Toolkit für maschinelles Lernen (ML), das auf Kubernetes aufbaut. Kubeflow wurde ursprünglich für ML-Workloads entwickelt, bietet aber auch leistungsfähige Werkzeuge für die Datentechnik. Damit lassen sich skalierbare, flexible und effiziente Datenpipelines erstellen.
In diesem Beitrag zeigen wir anhand eines praxisnahen Anwendungsfalls, wie Kubeflow auf Kubernetes in der Datentechnik eingesetzt werden kann. Wir betrachten die Architektur, die Vorteile und den Einstieg mit einer einfachen Pipeline.
Warum Kubeflow verwenden?
Bevor wir auf die technischen Details eingehen, betrachten wir kurz, warum Kubeflow für Aufgaben in der Datentechnik geeignet ist:
- Skalierbarkeit: Kubeflow nutzt die Skalierbarkeit von Kubernetes. So lassen sich Pipelines leichter horizontal skalieren und große Datenmengen mit wenig manuellem Aufwand verarbeiten.
- Automatisierung & Orchestrierung: Mit Kubeflow Pipelines können Sie komplexe Datenworkflows automatisieren und orchestrieren, sodass sie reproduzierbar und einheitlich ausgeführt werden.
- Ressourcenverwaltung: Die Ressourcenverwaltung von Kubernetes für CPU, GPU und Arbeitsspeicher hilft, die Leistung von Datenverarbeitungsaufgaben zu optimieren und Workloads auf verfügbare Ressourcen zu verteilen.
- Flexibilität: Unterschiedliche Workloads wie ETL, Datenvorverarbeitung und das Training von ML-Modellen können in derselben Umgebung ausgeführt werden. Das reduziert den Aufwand für mehrere Systeme.
- Wiederverwendbarkeit: Modulare Kubeflow-Komponenten lassen sich in verschiedenen Workflows erneut einsetzen und sparen dadurch Zeit und Arbeit.
Anwendungsfall: Skalierbare Pipeline für Datenaufnahme und -verarbeitung
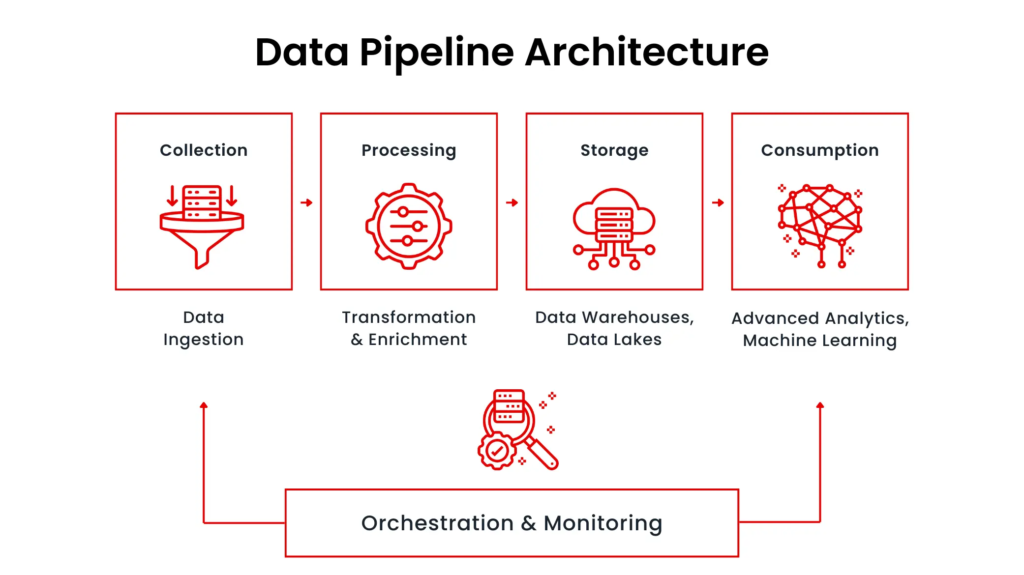
Nehmen wir an, wir entwickeln für eine E-Commerce-Plattform eine Pipeline zur Aufnahme und Verarbeitung von Daten. Sie soll:
- Daten aus mehreren Quellen aufnehmen, etwa Transaktionsprotokolle, Nutzeraktivitäten und Bestandssysteme.
- Die Daten vorverarbeiten, einschließlich Filterung, Transformation und Aggregation.
- Die verarbeiteten Daten für Analysen in ein Data Warehouse oder für ML-Anwendungen in einen Feature Store laden.
Überblick über die Architektur
Datenquellen: Die Rohdaten können beispielsweise aus Apache Kafka, REST-APIs oder Data Lakes wie Amazon S3 und Google Cloud Storage stammen.
Datenaufnahme: Mit Kubeflow Pipelines orchestrieren wir die Aufnahme der Rohdaten in die Pipeline.
Datenverarbeitung: Nach der Aufnahme führen containerisierte Aufgaben verschiedene Transformationen und Aggregationen aus.
Datenspeicherung: Die transformierten Daten werden in einem Data Warehouse wie Google BigQuery, Snowflake oder Amazon Redshift oder in einem Feature Store für ML-Modelle gespeichert.
Komponenten in Kubeflow
- Kubeflow Pipelines: Das Rückgrat der Datenpipeline; hier werden Workflows definiert, geplant und überwacht.
- Argo Workflows: Die Ausführungsengine für Pipeline-Aufgaben auf Kubernetes.
- Kubernetes: Stellt die zugrunde liegende Infrastruktur bereit, um containerisierte Anwendungen und Workflows zu skalieren und zu verwalten.
- Persistenter Speicher: Für Zwischen- und Endergebnisse können Kubernetes Persistent Volumes (PVs) oder Cloud-Speicherlösungen verwendet werden.
Schritt für Schritt: Aufbau der Pipeline
1. Kubeflow auf Kubernetes einrichten
Zuerst müssen Sie Kubeflow auf Ihrem Kubernetes-Cluster installieren. Folgen Sie dazu der Kubeflow-Installationsanleitung für Ihren bevorzugten Cloud-Anbieter (AWS, GCP, Azure) oder für eine lokale Umgebung mit Minikube oder Kind.
Sobald Kubeflow läuft, können Sie über das Kubeflow-Dashboard Pipelines, Experimente und Workflows verwalten.
2. Die Datenpipeline entwerfen
In Kubeflow Pipelines definieren Sie jeden Schritt der Datenpipeline als eigenständige Komponente. Jede Komponente ist eine containerisierte Aufgabe, beispielsweise für die Datenaufnahme, Transformation oder Speicherung.
Eine vereinfachte Pipeline könnte so aussehen:
- Schritt 1: Daten aufnehmen
- Eine Python-basierte Komponente ruft Daten aus mehreren Quellen ab, etwa Kafka-Streams und APIs.
- Diese Komponente kann parallel ausgeführt werden und gleichzeitig Daten aus mehreren Quellen aufnehmen.
- Schritt 2: Daten transformieren
- Nach der Aufnahme werden die Daten an einen weiteren Container übergeben, der sie bereinigt, filtert oder aggregiert. Beispielsweise kann in diesem Schritt ein Spark-Job mit der Kubernetes-Unterstützung für verteilte Systeme laufen.
- Schritt 3: Daten speichern
- Zum Schluss werden die verarbeiteten Daten in ein Data Warehouse oder einen Feature Store geladen. Dafür können Konnektoren für BigQuery und Redshift oder eine eigene API eingesetzt werden.
Jeder dieser Schritte wird als Komponente in der Pipeline definiert und kann unabhängig oder nacheinander ausgelöst werden.
3. Die Pipeline mit Kubeflow Pipelines orchestrieren
Kubeflow Pipelines verwendet ein Python-SDK zur Definition von Pipelines. Sie definieren die Schritte in Python und erstellen damit einen gerichteten azyklischen Graphen (DAG), der den Ausführungsablauf darstellt.
Der folgende kurze Ausschnitt veranschaulicht die Definition einer Pipeline:
import kfp
from kfp import dsl
@dsl.pipeline(
name=“Data Ingestion Pipeline“,
description=“Ingests and processes data“
)
def data_pipeline():
ingest_op = kfp.components.load_component_from_file(‚components/ingest.yaml‘)()
transform_op = kfp.components.load_component_from_file(‚components/transform.yaml‘)(ingest_op.output)
load_op = kfp.components.load_component_from_file(‚components/load.yaml‘)(transform_op.output)
if __name__ == ‚__main__‘:
kfp.Client().create_run_from_pipeline_func(data_pipeline, arguments={})
In diesem Beispiel ist jeder Schritt zur Wiederverwendung in einer YAML-Datei definiert. Die Komponenten können nach Bedarf angepasst werden.
4. Überwachung und Skalierung
Sobald die Pipeline läuft, können Sie sie im Kubeflow-Pipelines-Dashboard überwachen. Dort sehen Sie den DAG als Diagramm und können für jede Aufgabe prüfen, ob sie abgeschlossen wurde, fehlgeschlagen ist oder erneut ausgeführt wird.
Ein wesentlicher Vorteil von Kubernetes ist, dass sich einzelne Komponenten je nach Bedarf skalieren lassen. Benötigt die Datenaufnahme zu Spitzenzeiten mehr Ressourcen, kann Kubernetes diesen Teil der Pipeline skalieren, ohne andere Komponenten zu beeinflussen.
5. Wiederverwendung und Versionierung
Komponenten von Kubeflow Pipelines können auch in mehreren Pipelines verwendet werden. Das ist besonders für größere Teams hilfreich: Eine einmal erstellte Transformationskomponente lässt sich ohne erneute Implementierung in einem anderen Workflow einsetzen.
Kubeflow bietet außerdem Versionierung. Damit können Sie Änderungen an Pipelines im Zeitverlauf verfolgen und sie leichter weiterentwickeln und verbessern.
Fazit: Kubeflow für die Datentechnik
Kubeflow auf Kubernetes bietet eine flexible und skalierbare Lösung für Datenpipelines. Ob Sie Terabytes an Daten aufnehmen oder komplexe Workflows mit zahlreichen Abhängigkeiten orchestrieren: Mit Kubeflow lässt sich alles über eine einheitliche Plattform verwalten.
Durch die Kombination von Kubernetes mit den Orchestrierungs- und Automatisierungsfunktionen von Kubeflow können Sie Datenpipelines entwickeln, die skalierbar, effizient, modular und gut wartbar sind.
Wenn Sie Ihre Datenpipelines modernisieren möchten, kann Kubeflow eine wertvolle Option für Ihr Team sein.